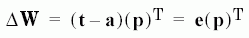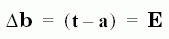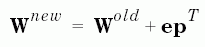感知器的學習規則 Perceptron Learning Rule
(原講義節錄 Matlab 手冊的英文說明,以下改寫為中文;公式改以 LaTeX 重排。)
感知器是用「期望行為的例子」來訓練的。期望行為可以整理成一組輸入/輸出配對
$$\{\mathbf p_1, t_1\},\ \{\mathbf p_2, t_2\},\ \dots,\ \{\mathbf p_Q, t_Q\}$$其中 \(\mathbf p\) 是網路的輸入,\(t\) 是對應的正確輸出(目標)。訓練的目的是縮小誤差 \(e = t - a\),也就是神經元輸出 \(a\) 與目標 \(t\) 的差。
Matlab 的感知器學習函數 learnp 根據輸入向量 \(\mathbf p\) 與誤差 \(e\),算出權值與偏權值該改多少。因為硬限制函數只能輸出 0 或 1,目標 \(t\) 也只能是 0 或 1。每執行一次 learnp,感知器就更有機會輸出正確結果。只要解存在(問題線性可分),感知器學習規則保證在有限次迭代內收斂。
三種情況 Three Cases
輸入一個向量 \(\mathbf p\)、算出輸出 \(a\) 後,單一神經元會遇到三種情況:
| 情況 | 輸出 | 誤差 e | 權值的變化 Δw | 效果 |
|---|---|---|---|---|
| 1. 分對 | a = t | 0 | 0(不改) | — |
| 2. 應為 1 卻輸出 0 | a = 0、t = 1 | +1 | \(+\mathbf p^{\mathsf T}\) | w 轉向 p,下次較可能把 p 判為 1 |
| 3. 應為 0 卻輸出 1 | a = 1、t = 0 | −1 | \(-\mathbf p^{\mathsf T}\) | w 轉離 p,下次較可能把 p 判為 0 |
若沒有偏權值,learnp 只改變權值向量 w,讓它指向該判為 1 的輸入、遠離該判為 0 的輸入,最後得到一條與 w 垂直、能正確分類的決策邊界。
學習規則 The Rule
三種情況可以合寫成一個式子。偏權值就是輸入恆為 1 的權值,所以同樣處理:
$$\Delta\mathbf w = (t - a)\,\mathbf p^{\mathsf T} = e\,\mathbf p^{\mathsf T},\qquad \Delta b = (t - a)(1) = e$$一層有多個神經元時,誤差與偏權值都是向量:
$$\Delta\mathbf W = (\mathbf t - \mathbf a)\,\mathbf p^{\mathsf T} = \mathbf e\,\mathbf p^{\mathsf T},\qquad \Delta\mathbf b = \mathbf t - \mathbf a = \mathbf e$$總結感知器學習規則:
$$\mathbf W^{\text{new}} = \mathbf W^{\text{old}} + \mathbf e\,\mathbf p^{\mathsf T},\qquad \mathbf b^{\text{new}} = \mathbf b^{\text{old}} + \mathbf e,\qquad \mathbf e = \mathbf t - \mathbf a$$決策邊界 Decision Boundary
決策邊界 L 是 \(\mathbf{Wp} + b = 0\) 的直線,把輸入平面分成兩個區域。L 與權值向量 \(\mathbf W\) 垂直,並依偏權值 \(b\) 平移。下圖中 \(w_{1,1} = -1\)、\(w_{1,2} = 1\)、\(b = 1\):L 左上方的輸入使淨輸入大於 0,硬限制神經元輸出 1;右下方的輸入輸出 0。
選擇不同的權值與偏權值,就能把分界線轉到任何方向、移到任何位置。沒有偏權值時,分界線一定通過原點(圖中灰色虛線);加上偏權值後,感知器才能分開不在原點兩側的兩組輸入。
- 原圖把線上的點標為「Wp + b = 0,a = 0」。但 hardlim 的定義是 \(n \ge 0\) 時輸出 1,所以線上的點應該是 a = 1,本站的圖已改正。這一點有實際影響:下方 AND 的例子學到的分界線剛好通過 (1, 1),正是靠 hardlim(0) = 1 才分對(
verify_nn.py核對)。 - 原講義多神經元的偏權值公式寫成 \(\Delta\mathbf b = (\mathbf t - \mathbf a) = \mathbf E\),大寫 E 應與前後一致寫作小寫粗體 \(\mathbf e\)。
互動示範 Try It
(補充)從 \(\mathbf W = 0\)、\(b = 0\) 開始,依序輸入各樣本並套用學習規則。逐筆看每一步屬於哪種情況、權值怎麼變、分界線怎麼移動:
| 資料 | 結果(依序輸入、初值為 0) |
|---|---|
| AND | 修正 11 次,第 6 回合全部分對:\(\mathbf W = [2\ \ 1]\)、\(b = -3\) |
| OR | 修正 5 次,第 4 回合全部分對:\(\mathbf W = [1\ \ 1]\)、\(b = -1\) |
| 六點 | 修正 3 次,第 2 回合全部分對 |
| XOR | 永遠不收斂:找不到一條直線能把 (0,1)、(1,0) 與 (0,0)、(1,1) 分開 |
XOR 說明了單層感知器的極限:只能分類線性可分的問題。要解 XOR 這類問題,需要多層網路,以及能訓練隱藏層的方法,也就是後面的倒傳遞網路。
原圖對照(取自 Matlab 手冊)