感知器的訓練 Training
(原講義為 Matlab 手冊的英文截圖,以下改寫為中文,公式改以 LaTeX 重排。)
反覆用 sim 把輸入送進感知器、再用 learnp 依誤差修改權值與偏權值,只要問題是感知器解得了的,最後一定能找到解。把全部訓練輸入與目標走過一遍,稱為一個 pass(回合)。
函數 train 就是執行這個迴圈:每個回合依序處理指定的輸入,對每個輸入向量計算輸出、誤差,並調整網路。
注意 train 並不保證訓練出來的網路一定有效。得到新的 \(\mathbf W\) 與 \(\mathbf b\) 後,必須對每個輸入向量計算網路輸出,確認是否都達到目標。若沒有成功,可以再呼叫 train 多訓練幾個回合;或是分析問題,看它是否適合用感知器解(感知器解不了的問題,例如XOR)。
手算一遍 Working Through a Simple Problem
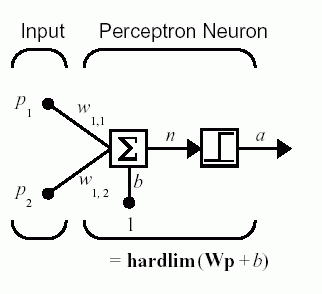
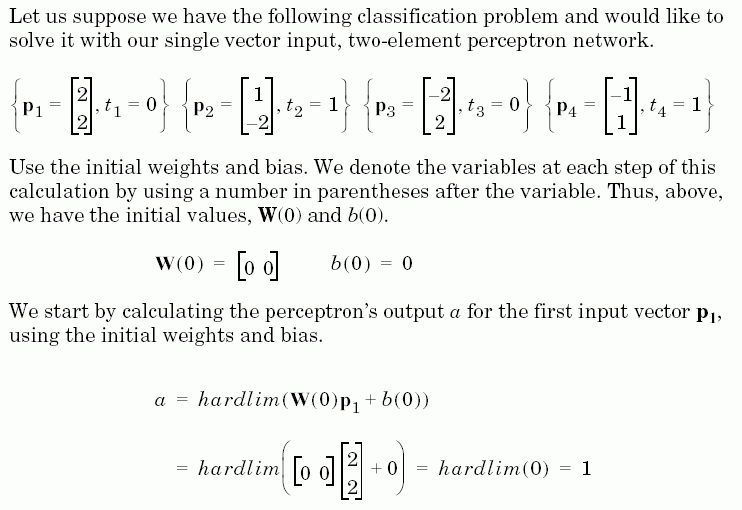
以一個神經元、兩元素輸入向量的感知器為例(同感知器神經元,R = 2),要解下面的分類問題:
$$\left\{\mathbf p_1 = \begin{bmatrix}2\\2\end{bmatrix}, t_1 = 0\right\}\ \left\{\mathbf p_2 = \begin{bmatrix}1\\-2\end{bmatrix}, t_2 = 1\right\}\ \left\{\mathbf p_3 = \begin{bmatrix}-2\\2\end{bmatrix}, t_3 = 0\right\}\ \left\{\mathbf p_4 = \begin{bmatrix}-1\\1\end{bmatrix}, t_4 = 1\right\}$$用預設的初值 \(\mathbf W(0) = [0\ \ 0]\)、\(b(0) = 0\);括號中的數字表示第幾步。第一個輸入:
$$a = \operatorname{hardlim}(\mathbf W(0)\mathbf p_1 + b(0)) = \operatorname{hardlim}\!\left([0\ \ 0]\begin{bmatrix}2\\2\end{bmatrix} + 0\right) = \operatorname{hardlim}(0) = 1$$輸出不等於目標 \(t_1 = 0\),用感知器規則依誤差修正:
$$e = t_1 - a = 0 - 1 = -1,\qquad \Delta\mathbf W = e\,\mathbf p_1^{\mathsf T} = (-1)[2\ \ 2] = [-2\ \ {-2}],\qquad \Delta b = e = -1$$ $$\mathbf W(1) = \mathbf W(0) + \Delta\mathbf W = [-2\ \ {-2}],\qquad b(1) = b(0) + \Delta b = -1$$接著輸入 \(\mathbf p_2\):
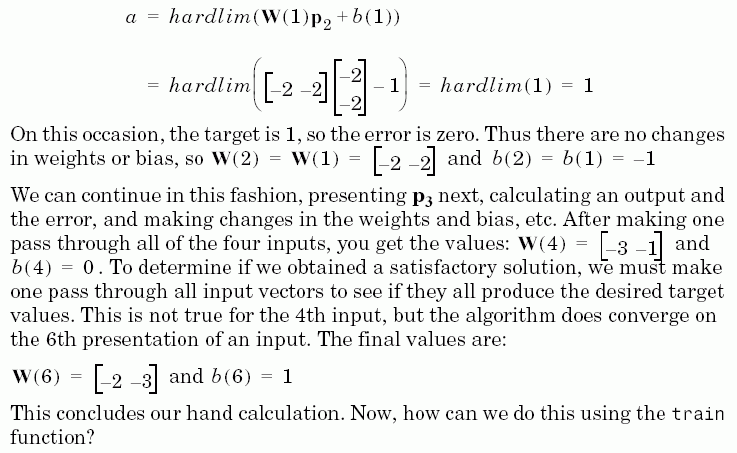
$$a = \operatorname{hardlim}(\mathbf W(1)\mathbf p_2 + b(1)) = \operatorname{hardlim}\!\left([-2\ \ {-2}]\begin{bmatrix}1\\-2\end{bmatrix} - 1\right) = \operatorname{hardlim}(1) = 1$$這次目標是 1,誤差為 0,權值與偏權值不變:\(\mathbf W(2) = \mathbf W(1)\)、\(b(2) = b(1)\)。照這樣繼續下去,全部步驟如下(補充:以 verify_nn2.py 逐步核對):
| 步 | 回合 | 輸入 | n | a | t | e | 之後的 W | 之後的 b |
|---|---|---|---|---|---|---|---|---|
| 1 | 1 | p₁ | 0 | 1 | 0 | −1 | [−2 −2] | −1 |
| 2 | 1 | p₂ | 1 | 1 | 1 | 0 | [−2 −2] | −1 |
| 3 | 1 | p₃ | −1 | 0 | 0 | 0 | [−2 −2] | −1 |
| 4 | 1 | p₄ | −1 | 0 | 1 | +1 | [−3 −1] | 0 |
| 5 | 2 | p₁ | −8 | 0 | 0 | 0 | [−3 −1] | 0 |
| 6 | 2 | p₂ | −1 | 0 | 1 | +1 | [−2 −3] | 1 |
| 7 | 2 | p₃ | −1 | 0 | 0 | 0 | [−2 −3] | 1 |
| 8 | 2 | p₄ | 0 | 1 | 1 | 0 | [−2 −3] | 1 |
| 9~12 | 3 | p₁~p₄ | −9、5、−1、0 | 0、1、0、1 | 0、1、0、1 | 全為 0 | [−2 −3] | 1 |
走完第一回合得到 \(\mathbf W(4) = [-3\ \ {-1}]\)、\(b(4) = 0\)。再用全部輸入檢查一次,第 4 個以外並不都對;演算法在第 6 次輸入時收斂,最後的值為 \(\mathbf W(6) = [-2\ \ {-3}]\)、\(b(6) = 1\)。
- 原講義第二步的式子把 \(\mathbf p_2\) 寫成 \([-2\ \ {-2}]^{\mathsf T}\),應為 \([1\ \ {-2}]^{\mathsf T}\)。巧的是用錯的向量算出 \(4 + 4 - 1 = 7\),結果同樣是 hardlim = 1,所以後面的數字都對。上面已改正。
- 第 1 步與最後的 \(\mathbf p_4\) 都剛好 n = 0,依 hardlim(0) = 1 才得到表中的結果:最後的邊界正好通過 \(\mathbf p_4\)。
用 train 訓練 Using train
下面的程式建立如上的感知器,初值為 0。先只看一個輸入 \(\mathbf p = [2;\ 2]\)、目標 \(t = 0\),並把 epochs 設為 1,讓 train 只走過輸入一次:
net = newp([-2 2; -2 +2], 1);
p = [2; 2];
t = [0];
net.trainParam.epochs = 1;
net = train(net, p, t);
w =
    -2    -2
b =
    -1
只用第一個向量訓練後,權值與偏權值為 [−2 −2] 與 −1,和手算一樣。接著輸入 \(\mathbf p_2\),輸出是 1;目標也是 1,誤差為 0,不會改變。可以這樣一個接一個輸入,但用 train 可以自動完成。用全部四個輸入訓練一個回合:
net = newp([-2 2; -2 +2], 1);
net.trainParam.epochs = 1;
p = [[2;2] [1;-2] [-2;2] [-1;1]];
t = [0 1 0 1];
net = train(net, p, t);
w =
    -3    -1
b =
     0
與手算第一回合的結果相同。模擬訓練後的網路:
a = sim(net, p)
a =
    [0]    [0]    [1]    [1]
輸出還不等於目標,需要訓練更多回合。試試四個回合:
TRAINC, Epoch 0/20
TRAINC, Epoch 3/20
TRAINC, Performance goal met.網路在第三回合輸入時已經訓練完成。手算時網路在第 6 次輸入(第二回合中間)就收斂了,但要到第三回合把每個輸入都檢查過才能確認。最後的權值與偏權值為 w = [−2 −3]、b = 1,模擬輸出 a = [0 1 0 1],誤差全為 0,訓練成功。
原文說 newp 建立的網路預設訓練函數是 trains(可用 net.trainFcn 查看):它以最純粹的形式套用感知器規則,依序逐一輸入,每輸入一個向量就修正一次。因此除非問題是單層感知器解不了的,用 train 訓練感知器一定會在有限步內收斂。
TRAINC,結尾卻說預設訓練函數是 trains。課程附檔 NnetAnd.mat(以 newp 建立)可以釐清:net.trainFcn = 'trainc'、net.adaptFcn = 'trains'。所以用 train 時跑的是 trainc(逐筆的循環訓練),trains 是 adapt 用的。另外原文的誤差寫成 a(i) − t(i),與前面 e = t − a 的定義正負相反;這裡全為 0,不影響結論。還有,原文說「試試四個回合」,輸出卻顯示 Epoch 0/20(上限 20 回合),兩者不一致;原文沒有附這一段的程式碼。原圖對照(取自 Matlab 手冊)